현실의 업무에는 예상하지 못한 상황이 자주 생깁니다. 파일이 없을 수도 있고, 검색 결과가 부족할 수도 있으며, 도구가 오류를 반환할 수도 있습니다. 그래서 실용적인 AI 에이전트는 긴 계획을 한 번에 확정하기보다, 목표를 이해한 뒤 한 단계씩 행동하고 결과를 확인하면서 다음 행동을 정합니다.
이번 글에서는 이 반복 구조를 Plan → Act → Observe → Update 흐름으로 나누어 살펴보고, 언제 멈추고 언제 사용자에게 물어봐야 하는지도 함께 알아보겠습니다.
1. 한 번의 답변과 에이전트의 작업은 다르다
한 번의 모델 호출은 입력을 받고 결과를 반환하면 끝납니다. 반면 여러 단계가 필요한 업무에서는 첫 번째 행동의 결과가 다음 행동을 바꿉니다. AI 에이전트는 이런 변화를 처리하기 위해 판단과 실행을 반복하는 Agent Loop를 사용합니다.
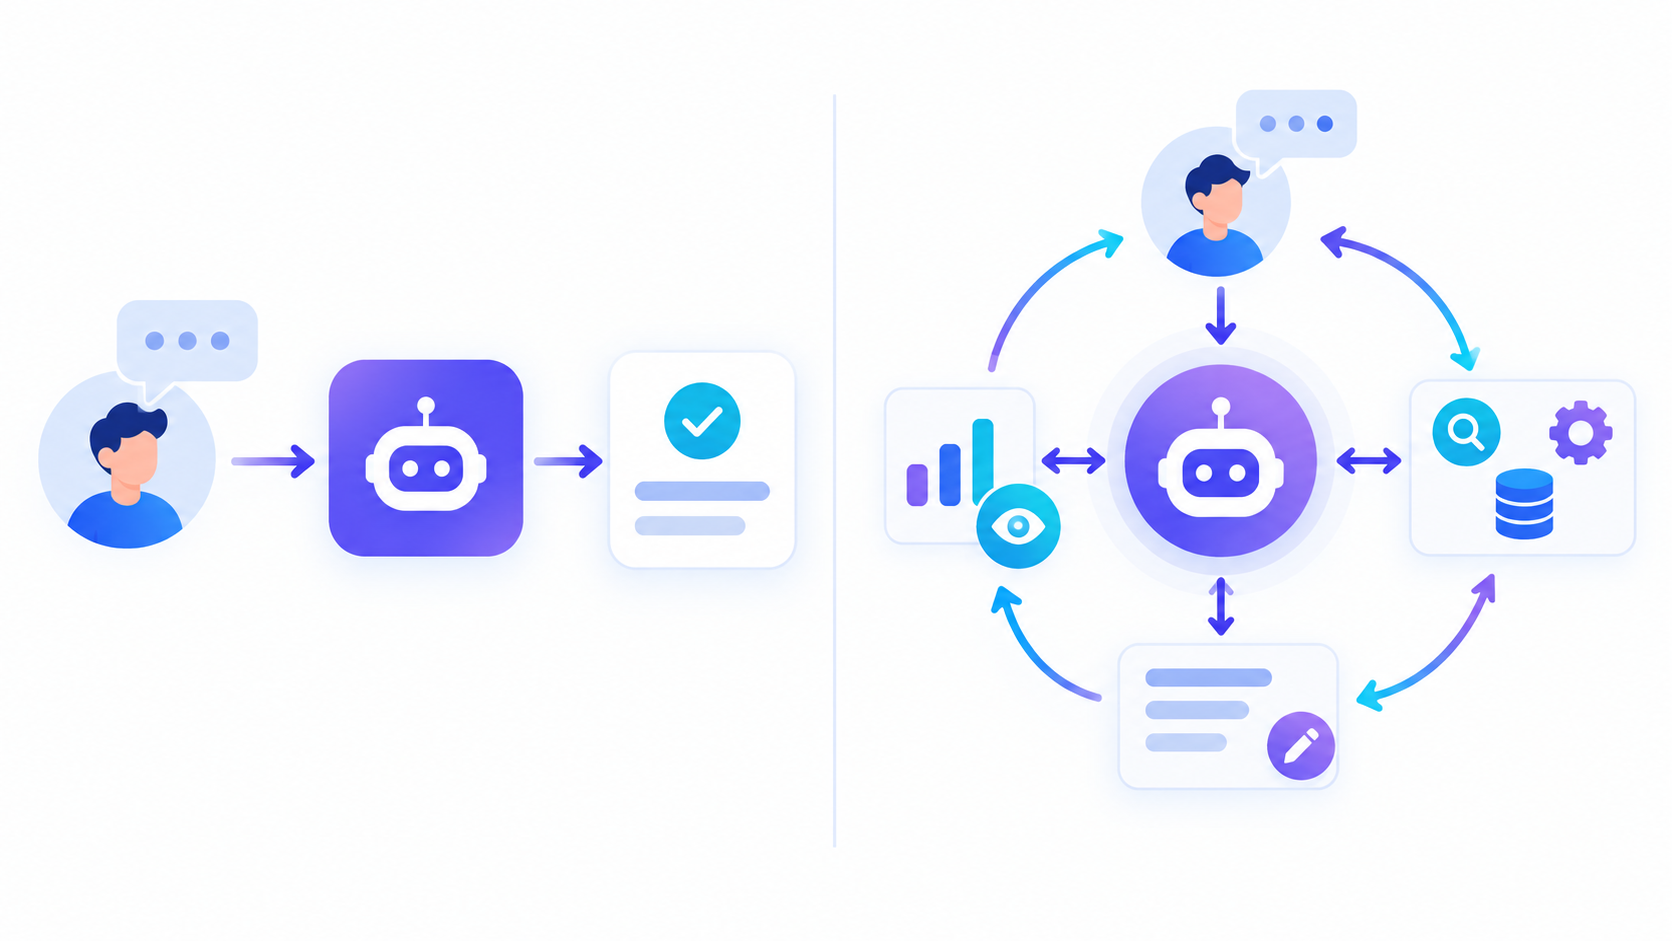
정해진 한두 단계로 충분하다면 일반 모델 호출이나 고정 워크플로가 더 빠르고 저렴하며 예측하기 쉽습니다. 필요한 단계가 미리 정해지지 않는 작업에서 Agent Loop의 가치가 커집니다.
2. 첫 단계는 목표와 성공 조건을 분명히 하는 것이다
에이전트가 계획을 세우기 전에 먼저 알아야 할 것은 “무엇을 하면 끝난 것인가”입니다. “경쟁사를 조사해줘”보다 조사 대상, 비교 항목, 기준 날짜, 결과 형식이 포함된 목표가 훨씬 안전합니다.

| 목표에 필요한 정보 | 확인할 질문 | 예시 |
|---|---|---|
| 범위 | 어디까지 처리해야 하는가? | 경쟁사 3곳의 공개 정보만 조사 |
| 성공 조건 | 무엇이 있어야 완료인가? | 가격·핵심 기능·차별점 표 작성 |
| 제약 조건 | 하면 안 되는 일은 무엇인가? | 로그인 우회나 비공개 정보 접근 금지 |
| 결과 형식 | 어떻게 전달해야 하는가? | 출처 링크가 포함된 요약 보고서 |
이 정보가 부족하면 에이전트는 필요한 질문을 먼저 해야 합니다. 모호한 상태에서 임의로 범위를 넓히는 것은 계획 능력이 아니라 불필요한 추측입니다.
3. 계획은 지도이고 다음 행동은 한 걸음이다
계획은 전체 방향을 보여주지만, 실제 실행은 현재 상황에서 가장 적절한 한두 단계부터 시작합니다. 처음 만든 계획은 가설에 가깝기 때문에 도구 결과를 확인하기 전까지 모든 세부 단계를 확정할 필요가 없습니다.
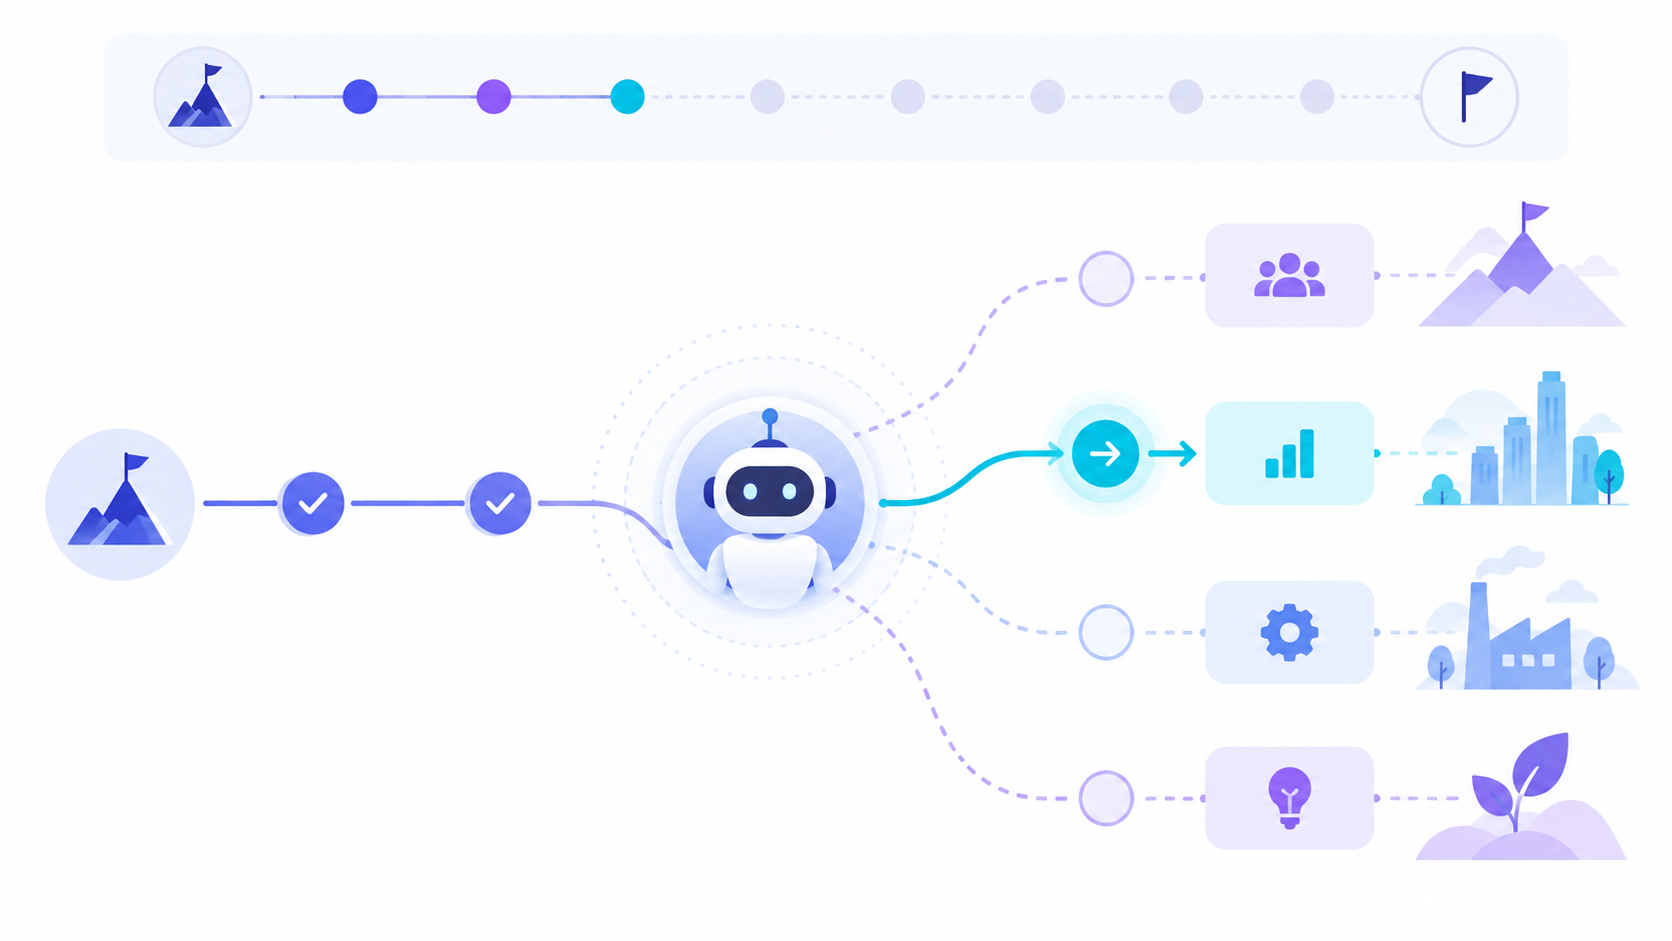
사용자에게는 작업 단계, 선택한 도구, 진행 상태, 근거와 변경 사항처럼 검증에 필요한 정보를 보여주는 것이 중요합니다. 모델의 내부 추론 전체를 노출하는 것과 투명한 작업 기록은 구분해야 합니다.
4. Plan → Act → Observe → Update가 반복된다
Agent Loop의 중심은 네 단계입니다. 목표와 현재 상태를 보고 다음 행동을 정한 뒤, 도구를 실행하고 그 결과를 관찰합니다. 관찰 결과가 예상과 다르면 계획과 상태를 갱신합니다.
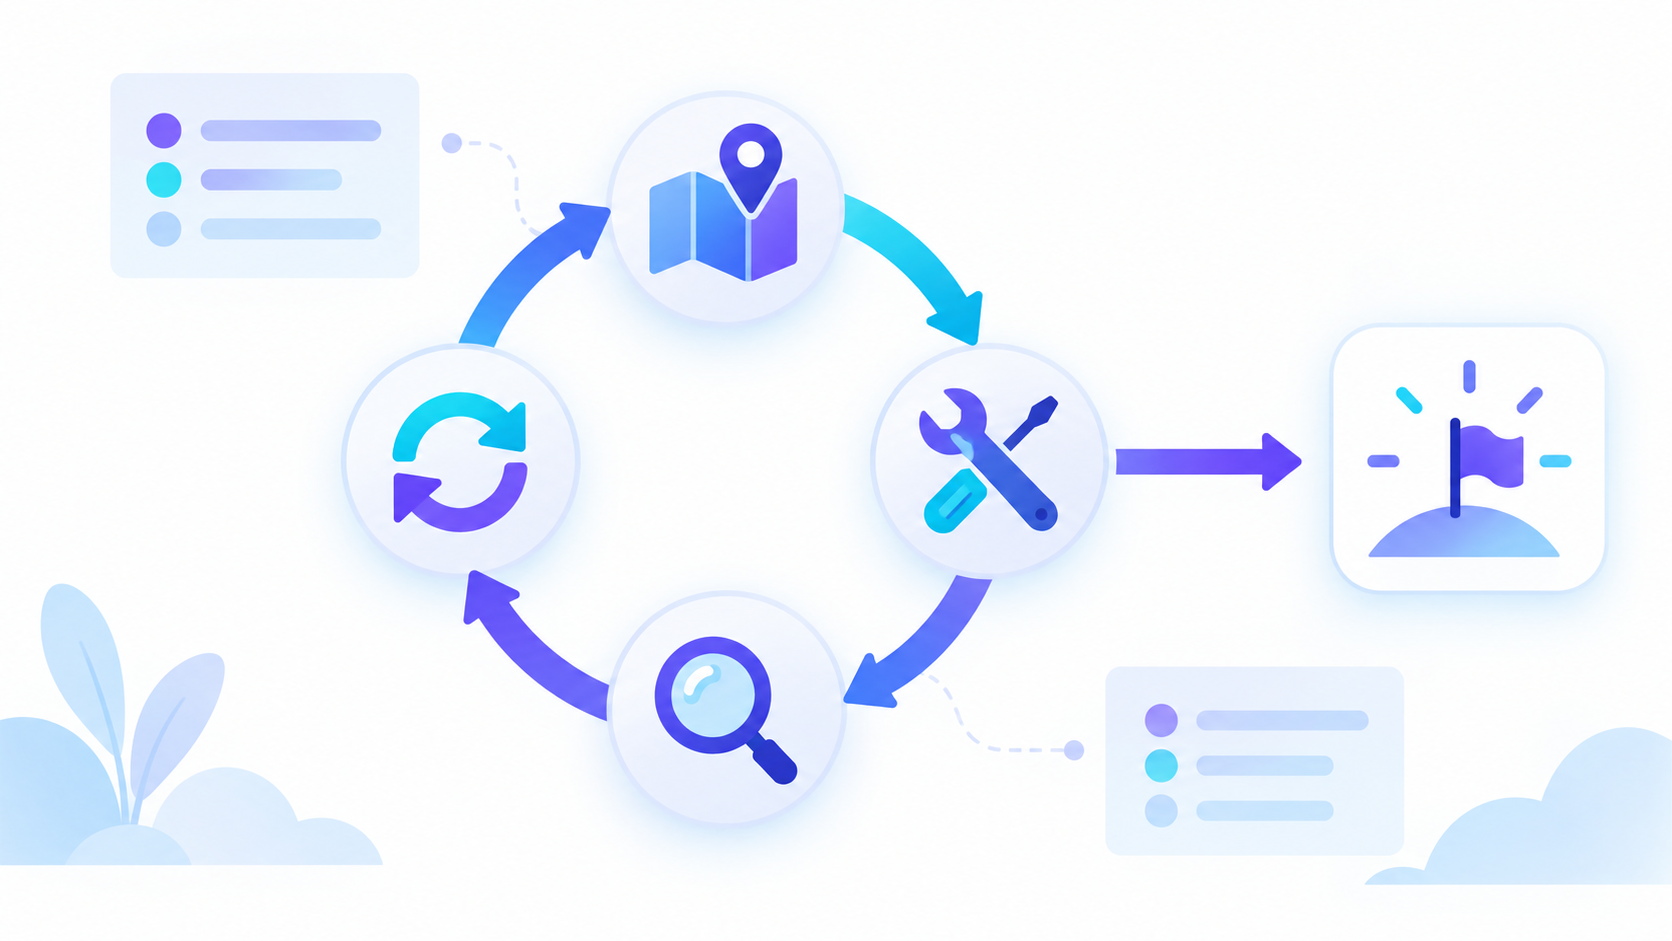
↓
Act · 도구 호출 또는 사용자에게 질문
↓
Observe · 결과, 오류, 변경된 환경 확인
↓
Update · 작업 상태와 계획 수정
↓
완료 조건을 만족하지 않았다면 다시 반복
ReAct 연구는 판단과 행동을 번갈아 수행하면서 외부 환경에서 정보를 얻고, 그 관찰을 이용해 상위 계획을 유지하거나 수정하는 접근을 제시했습니다. 실제 제품 구현은 서로 다르지만, 행동 결과가 다음 판단의 근거가 된다는 원리는 널리 쓰입니다.
5. 관찰은 추측이 아니라 실제 결과여야 한다
에이전트가 계획을 수정하려면 환경에서 돌아온 실제 정보가 필요합니다. 검색 결과, 파일 내용, API 응답, 테스트 통과 여부, 변경된 레코드 등이 바로 관찰입니다. 도구를 호출했다고 성공한 것으로 가정하면 오류가 다음 단계로 누적됩니다.
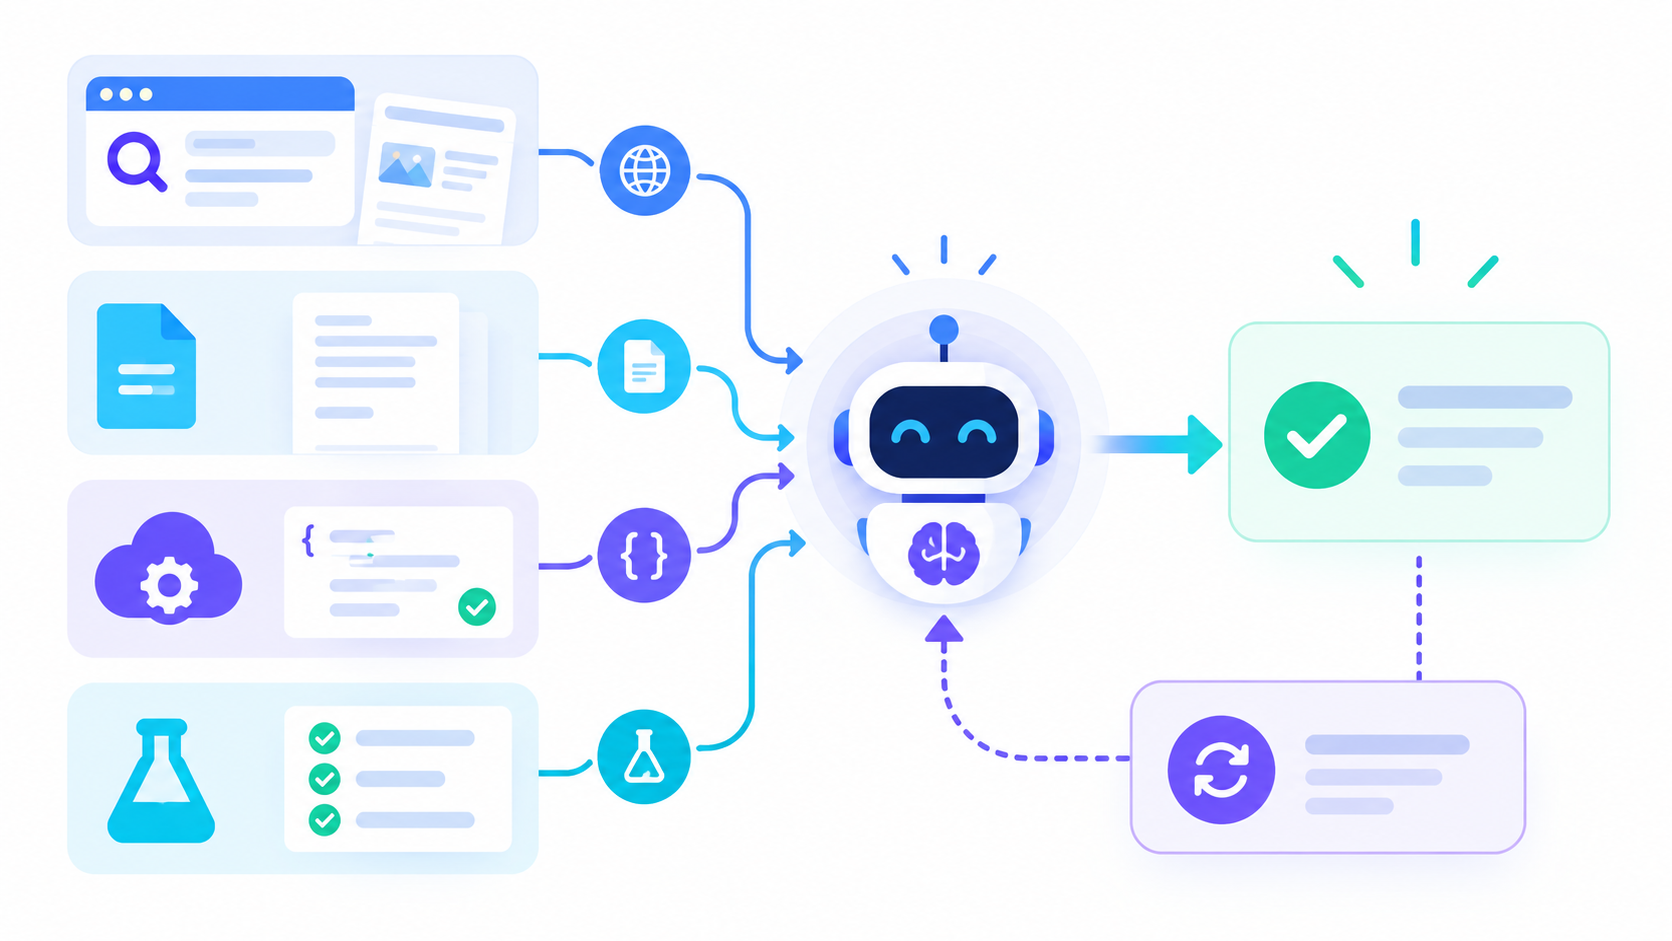
| 행동 | 관찰해야 할 결과 | 다음 판단 |
|---|---|---|
| 웹 검색 | 출처, 날짜, 검색 결과의 관련성 | 충분하면 정리, 부족하면 검색어 수정 |
| 파일 읽기 | 파일 존재 여부와 실제 내용 | 분석하거나 다른 위치 탐색 |
| 데이터 수정 | 성공 상태와 변경된 레코드 | 검증하거나 오류 복구 |
| 코드 실행 | 출력, 오류 로그, 테스트 결과 | 완료하거나 코드 수정 후 재실행 |
“찾았다”라는 요약만 남기지 말고 어느 도구에서 언제 어떤 결과가 왔는지 기록해야 나중에 오류를 추적하고 사용자가 근거를 확인할 수 있습니다.
6. 실제 업무에서는 계획이 이렇게 바뀐다
“이번 주 회의 자료를 찾아 핵심 결정과 할 일을 정리해줘”라는 업무를 예로 들어보겠습니다. 에이전트는 문서 검색부터 시작하지만, 검색 결과에 최신 회의록이 없다면 계획을 수정해야 합니다.
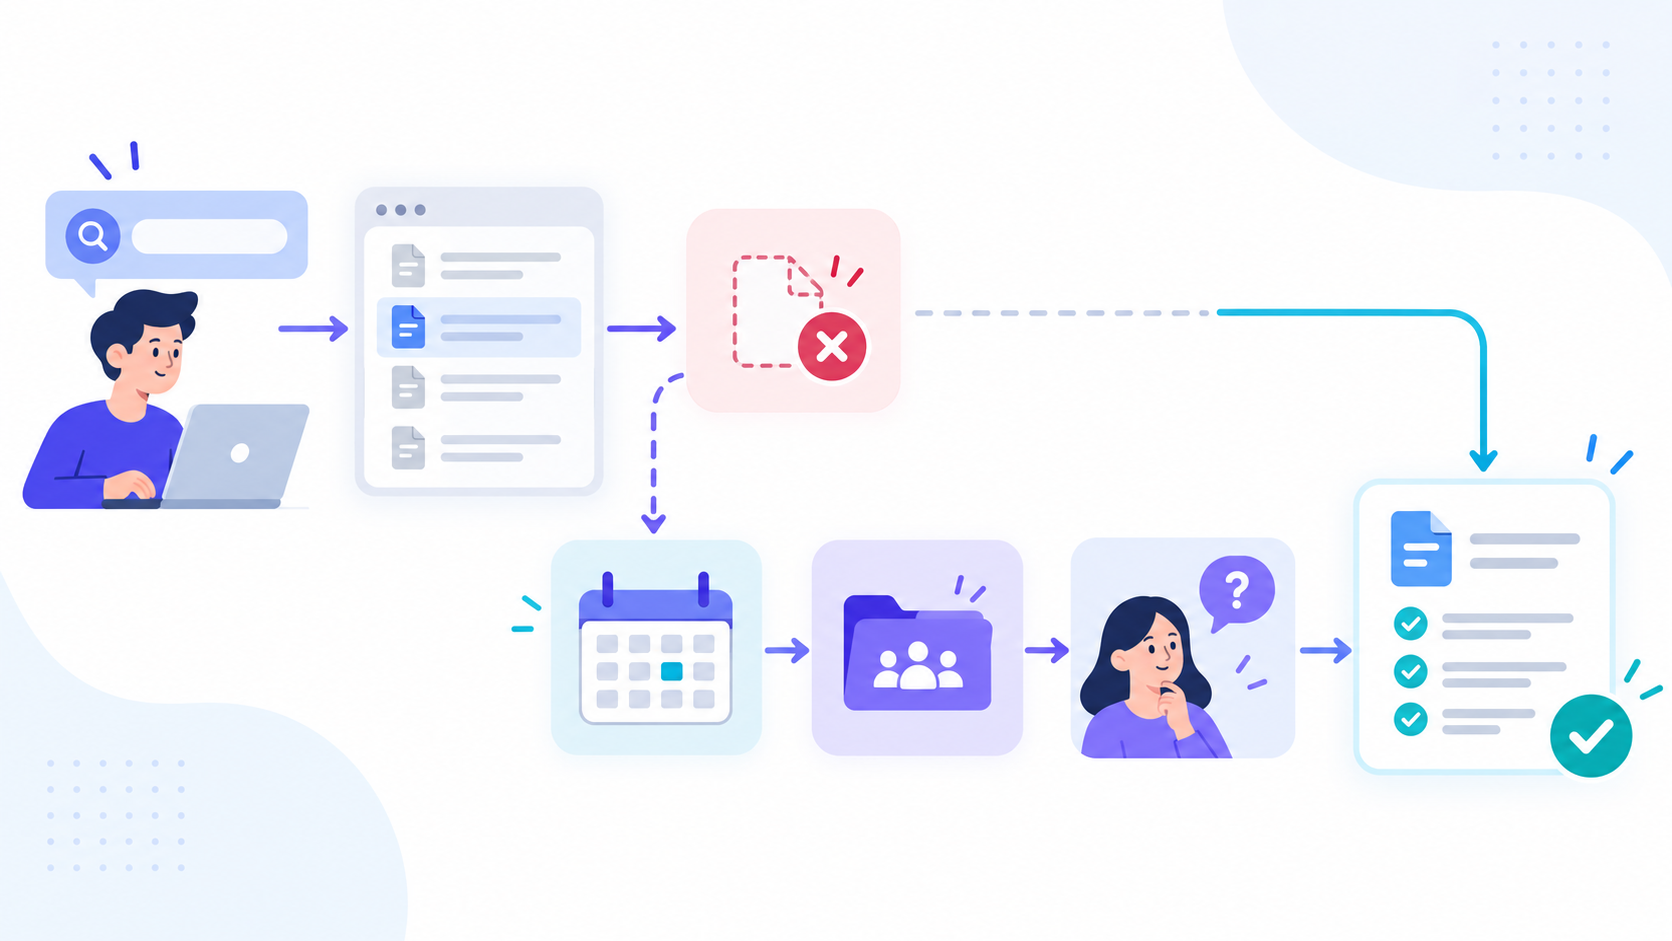
↓
최신 회의록 누락 관찰
↓
캘린더에서 회의 날짜와 참석자 확인
↓
허용된 공유 폴더를 추가 검색
↓
여전히 없으면 사용자에게 위치 질문
↓
자료를 찾은 뒤 결정 사항과 할 일 추출·검증
좋은 에이전트는 같은 실패한 호출을 무한히 반복하지 않습니다. 입력값을 바꿀 근거가 있는지 확인하고, 대체 경로가 없거나 권한이 필요하면 사용자의 판단을 요청합니다.
7. 멈춤 조건과 승인 지점이 반드시 필요하다
Agent Loop는 반복할 수 있기 때문에 언제 끝내야 하는지를 명확히 정해야 합니다. 완료 조건뿐 아니라 최대 반복 횟수, 시간·비용 한도, 연속 오류 횟수, 사용자 승인이 필요한 행동도 함께 설정합니다.
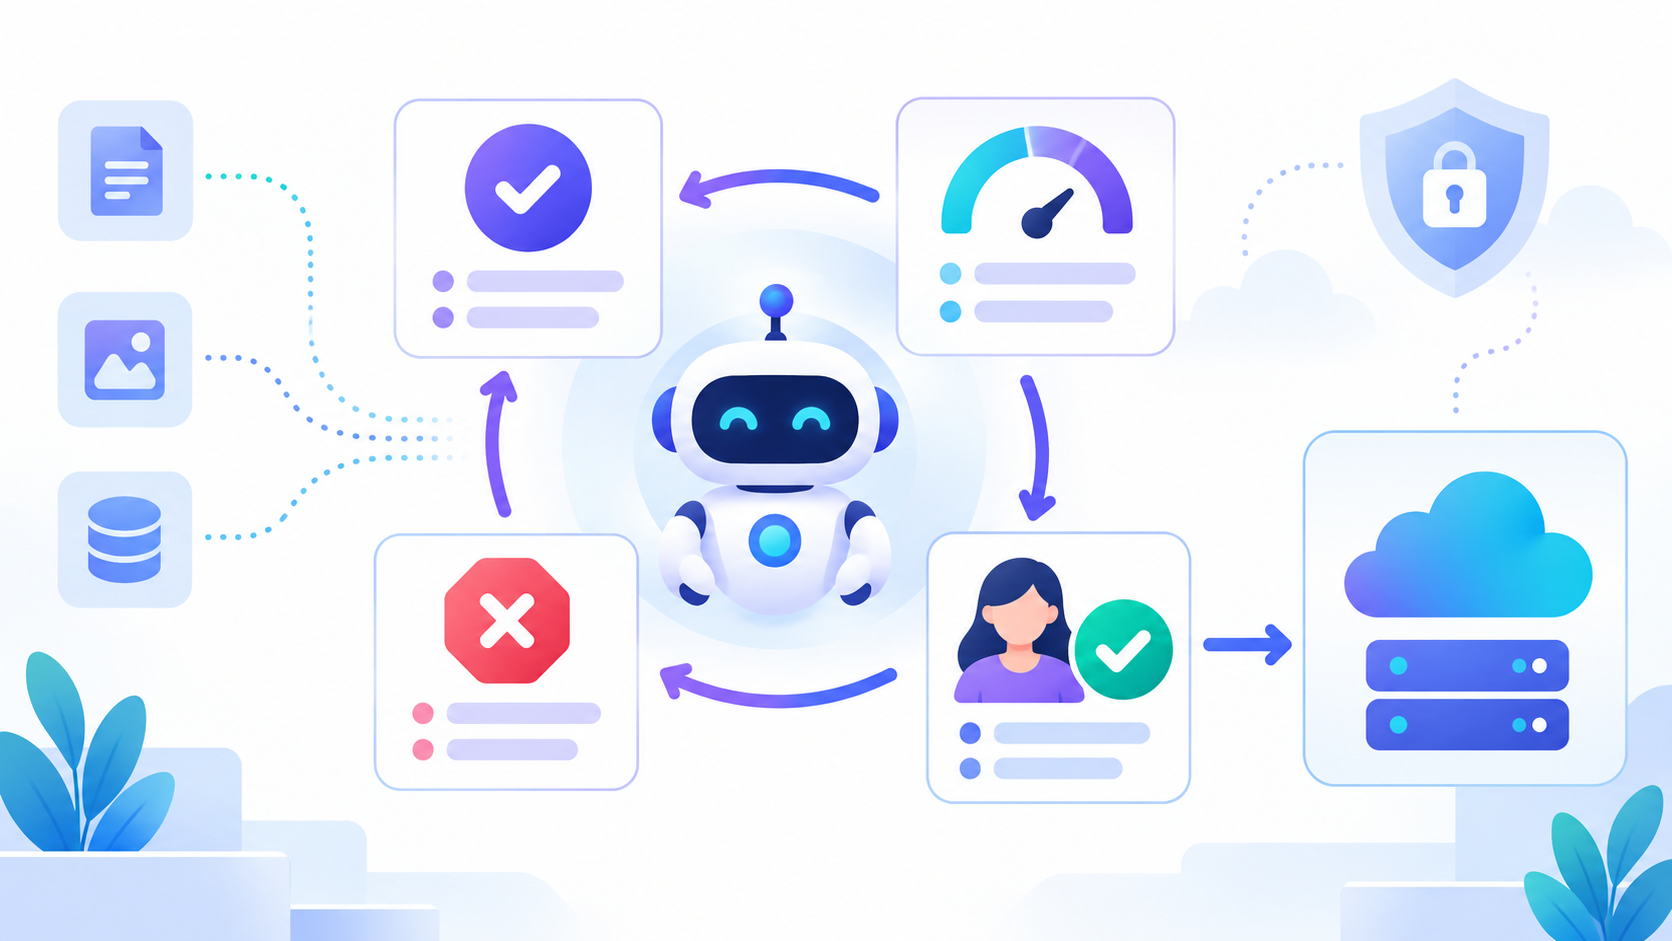
반복이 늘면 비용과 지연뿐 아니라 작은 오류가 누적될 가능성도 커집니다. 각 단계에서 진행률과 결과를 기록하고, 개선 없이 같은 행동이 반복되면 중단해야 합니다.
8. 핵심 정리
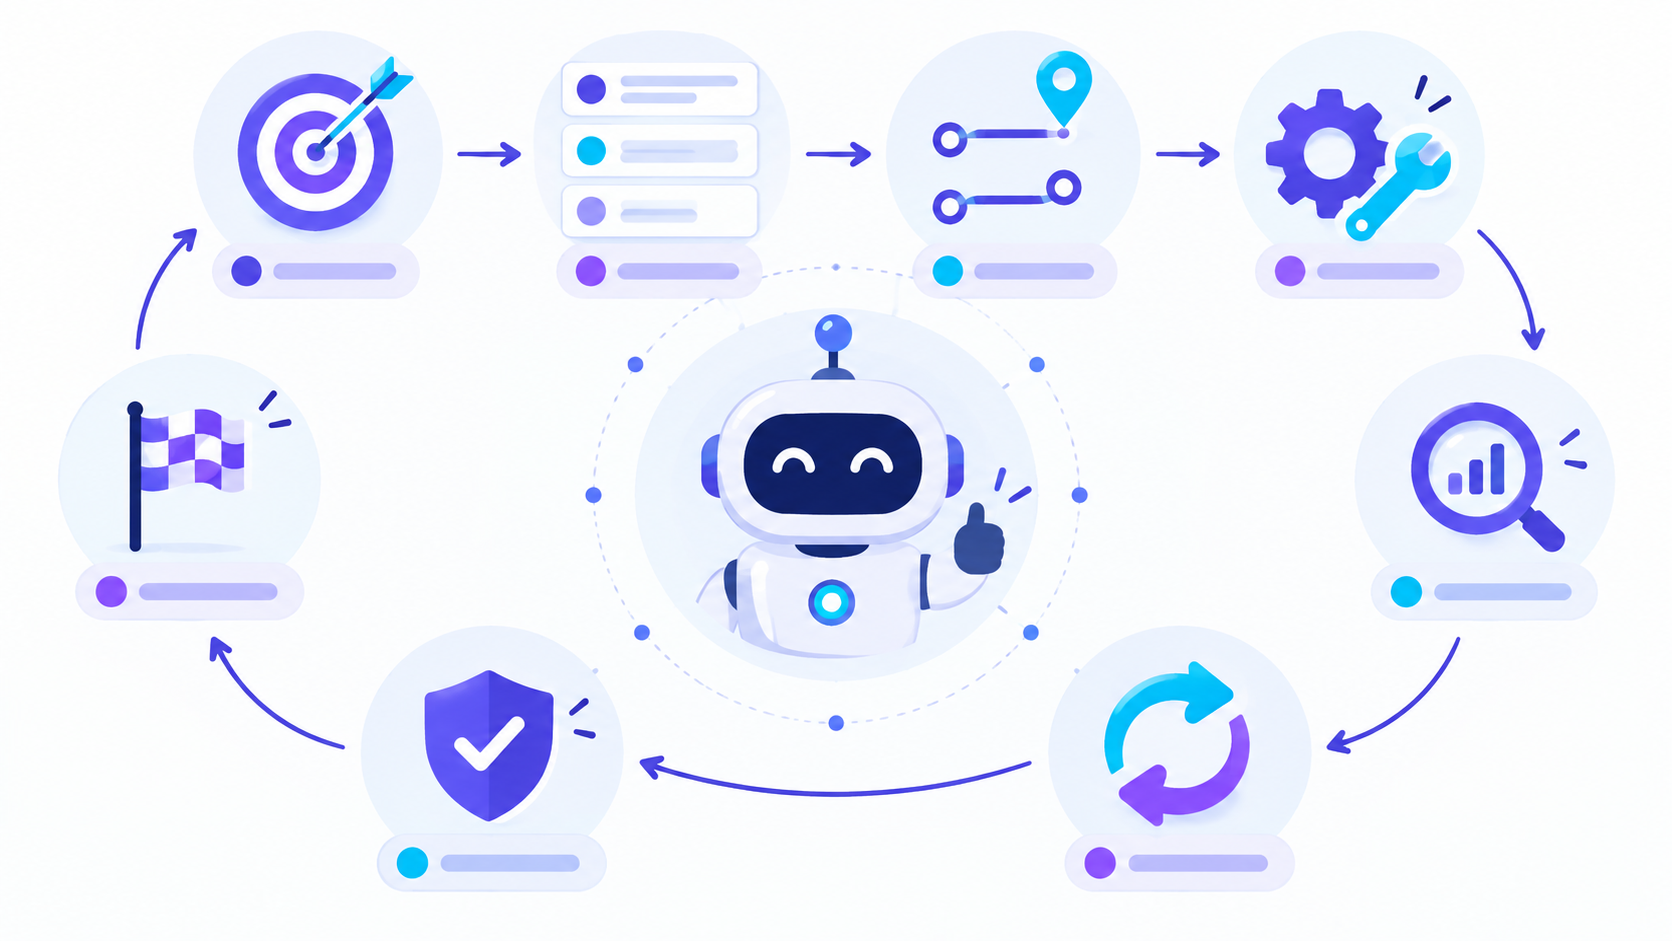
Goal = 목표와 성공 조건 Plan = 전체 방향 Act = 다음 행동 실행 Observe = 실제 결과 확인 Update = 계획과 상태 수정
AI 에이전트의 계획은 한 번 작성하고 끝나는 고정 문서가 아닙니다. 목표를 작은 단계로 나누고, 도구를 실행하고, 실제 결과를 관찰해 다음 행동을 바꾸는 과정입니다. 여기에 종료 조건, 최소 권한, 승인과 로그가 더해져야 통제 가능한 시스템이 됩니다.
다음 글에서는 에이전트가 외부 도구와 데이터를 공통된 방식으로 연결할 수 있도록 돕는 MCP가 무엇인지 살펴보겠습니다.
🔗 AI 에이전트 입문 시리즈
참고: Anthropic · Building Effective Agents, ReAct: Synergizing Reasoning and Acting in Language Models